Ontologies for Agents
seonest운영 중인 서비스에서 특정 이벤트(장애 발생 등)에 대해서 에이전트에게 물으면 에이전트는 무엇을 근거로 답할까요? 시스템과 사람이 남긴 문서, 기록, 데이터입니다. 그래서 에이전트에게 맡기는 일이 많아질수록 이 자료들이 얼마나 잘 정리되어 있는지가 중요합니다.
예를 들어 이전 장애 발생한 것에 대해서 "게이트웨이 타임아웃, 롤백으로 해결함"이라는 내용만 남아 있다고 해 보겠습니다. 장애를 직접 처리한 사람에게는 이 내용이면 충분합니다. 그때 무엇을 보고 원인을 찾았는지 기억하고 있기 때문입니다. 하지만 에이전트는 이번 상황에서 똑같이 롤백하면 되는지 아니면 다른 부분을 확인해야 하는지 판단할 수 없습니다. 에이전트가 판단하려면 이전 장애 처리 기록에서 무엇을 근거로 보고 처리했는지가 있어야 정확한 판단을 할 수가 있습니다.
그래서 결국 에이전트에게 일을 맡기려면, 어떤 대상이 있고 서로 어떻게 연결되는지를 에이전트도 읽을 수 있게 정리해 두어야 합니다. 그 방법 중 하나가 온톨로지입니다.
Netflix의 Prasanna Vijayanathan과 Renzo Sanchez-Silva는 배포 기록, 로그, 장애 기록, 그리고 사람들이 나눈 논의를 한 지식 그래프로 연결한 사례를 소개했습니다. 지식 그래프는 대상과 대상 사이의 관계를 함께 저장하므로 여러 시스템에 흩어져 있던 정보를 한 번에 조회할 수 있습니다. 이 시스템은 사람이 추론한 내용을 기록하고 각 가설에 증거와 신뢰도를 붙입니다. 이 글에서는 먼저 Netflix가 이 지식 그래프를 어떻게 만들었는지 살펴봅니다. 또한 어떻게 정리해야 에이전트가 잘 판단할 수 있을지도 함께 확인해 보겠습니다.
Netflix가 온톨로지를 만든 이유
Netflix는 여러 관측 도구를 함께 사용하고 도구마다 담고 있는 정보가 다릅니다. 텔레메트리 플랫폼인 Atlas에는 애플리케이션의 시계열 데이터가 쌓이고, 알림 시스템인 Radar에는 알림 이력이 쌓입니다. 온콜 순번은 PagerDuty에서, 배포 이력은 Spinnaker에서 관리합니다. 문제는 이 도구들이 같은 대상을 각각 애플리케이션, 서비스, 클러스터처럼 서로 다른 이름으로 부른다는 점입니다.
아래는 온톨로지가 없을 때 이 정보들이 어떤 모습인지 보여 주는 가상의 예시입니다. 세 기록은 모두 같은 게이트웨이의 기록입니다. 그런데 관측 도구마다 필드 이름도 다르고 값을 표기하는 방식도 다릅니다.
# 배포 도구의 기록
{ "application": "apigateway", "region": "us-east-1", "version": "2024.10.3" }

# 알림 도구의 기록
{ "service": "api-gateway-prod", "alert": "latency_p99_high" }

# 장애 관리 도구의 기록
{ "id": "INC-5377", "affected_cluster": "api-gw-useast1", "severity": "SEV 2" }
위 세 기록이 같은 게이트웨이에 대한 기록인지는 값만 봐서는 알 수 없습니다. apigateway, api-gateway-prod, api-gw-useast1이 같은 서비스라는 사실은 이 서비스를 잘 아는 몇몇 사람만 알고 있습니다. 그래서 여러 도구의 기록을 맞춰 보며 장애 원인을 찾으려면 그 사람들에게 물어볼 수밖에 없습니다. 이렇게 장애 대응이 소수의 사람에게 의존하면 그 사람들이 바쁘거나 자리에 없을 때 대응도 함께 늦어집니다.
에이전트에게 이 기록을 그대로 사용하기는 더 어렵습니다. 에이전트는 세 이름이 같은 서비스인지 확인할 수 없어서 이름만 보고 짐작할 수밖에 없습니다. 이름이 비슷하다는 이유로 서로 다른 서비스를 같은 서비스로 묶을 수도 있고, 반대로 같은 서비스를 서로 다른 서비스로 나눠 볼 수도 있습니다.
Netflix는 이 문제를 해결하려고 온톨로지를 만들었습니다. 온톨로지는 다루는 대상에 어떤 종류(타입)가 있는지, 각 타입이 어떤 속성을 가지는지, 그리고 타입끼리 어떤 관계를 맺을 수 있는지를 미리 정해 둔 것입니다. 예를 들어 "우리 운영 환경에는 애플리케이션과 장애가 있고, 장애는 애플리케이션에 영향을 줄 수 있다"라는 내용을 사람도 기계도 읽을 수 있게 적어 두면 그것이 온톨로지입니다.
Netflix는 이 온톨로지를 자체 형식 대신 W3C의 표준 형식으로 작성했습니다.
W3C란? W3C(World Wide Web Consortium)는 웹 기술의 표준을 정하는 국제 단체입니다. 웹을 처음 만든 팀 버너스리가 1994년에 세웠고, HTML과 CSS의 표준도 이곳에서 정합니다. W3C가 공식 표준으로 확정한 문서는 권고안(Recommendation)이라고 부릅니다.
버너스리는 웹에 있는 정보를 사람뿐 아니라 기계도 이해할 수 있도록 만들자는 구상을 내놓았는데, 이 구상을 시맨틱 웹(Semantic Web)이라고 부릅니다. 이 글에서 다루는 RDF, OWL, SPARQL, SHACL은 모두 시맨틱 웹을 위해 만들어진 표준입니다. RDF는 1999년, OWL은 2004년, SPARQL은 2008년, SHACL은 2017년에 권고안이 되었습니다. 오래전부터 쓰여 온 표준이라서, 이 표준들을 지원하는 데이터베이스와 라이브러리도 이미 많이 나와 있습니다.
온톨로지를 구성하는 요소
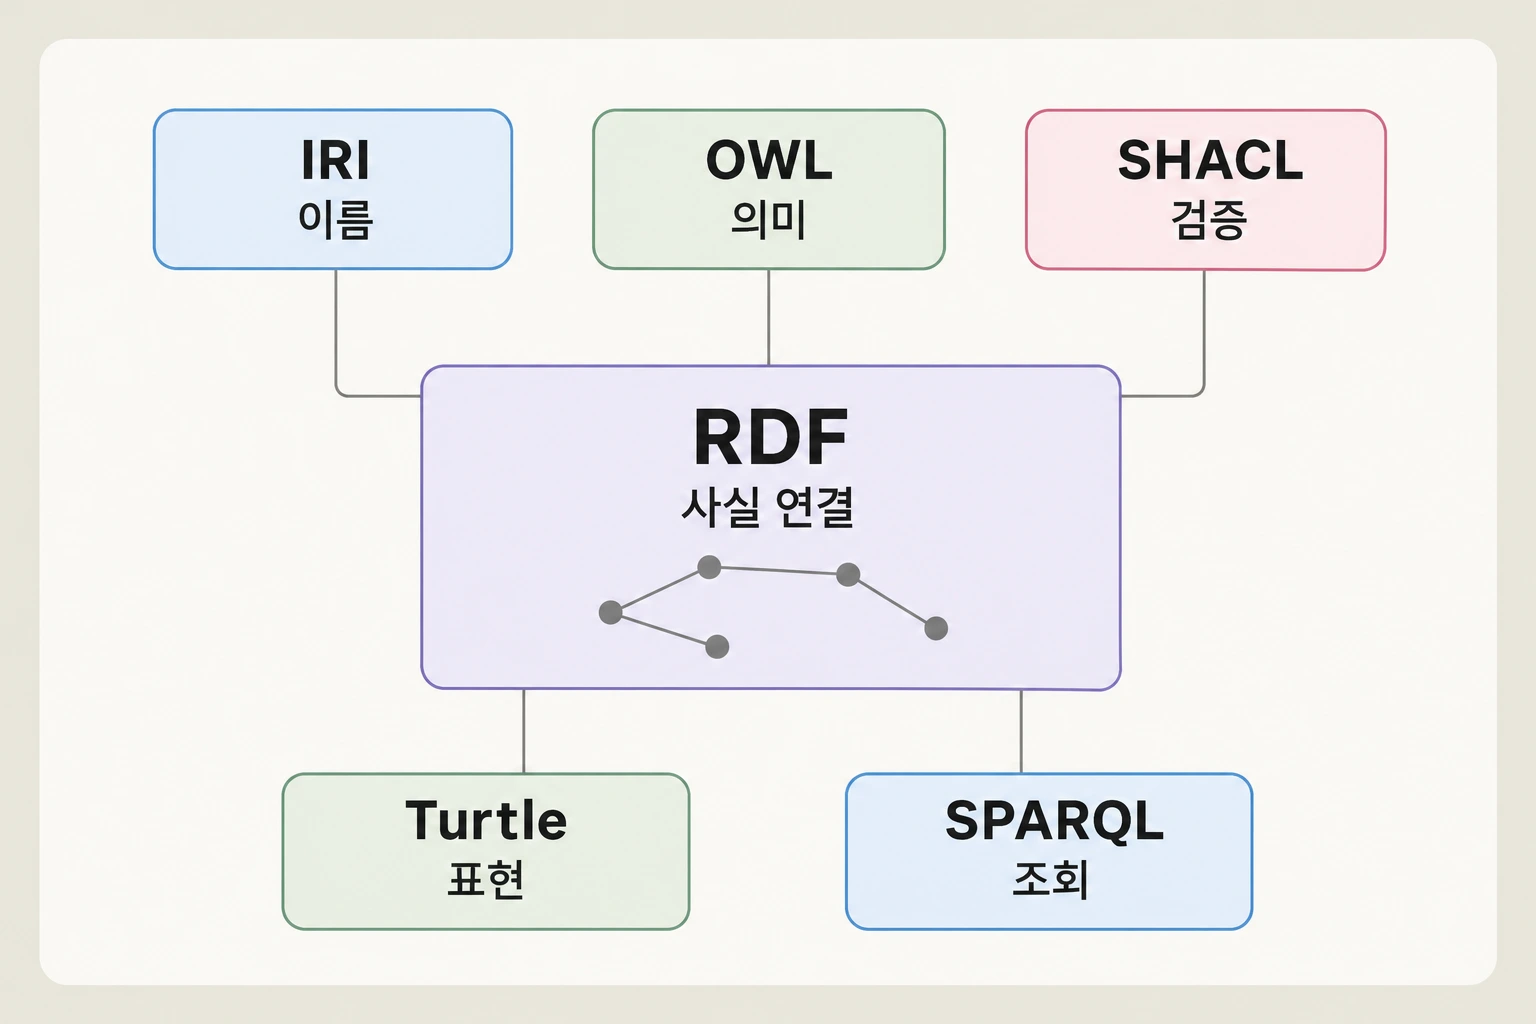
Netflix의 온톨로지는 여러 요소가 역할을 나누어 맡는 구조입니다. 각 요소의 원래 이름과 역할은 다음과 같습니다.
- RDF(Resource Description Framework): 모든 사실을 주어, 관계, 목적어의 세 부분으로 기록하는 데이터 모델입니다.
- IRI(Internationalized Resource Identifier)와 접두사: 대상과 관계에 서로 겹치지 않는 고유한 이름을 붙이는 방법입니다. IRI는 W3C가 아니라 인터넷 표준화 기구인 IETF가 정한 표준(RFC 3987)이며, RDF는 이름을 붙일 때 이 IRI를 사용합니다.
- Turtle(Terse RDF Triple Language): RDF 데이터를 사람이 읽을 수 있는 텍스트 파일로 저장하는 문법입니다.
- OWL(Web Ontology Language): 사용할 수 있는 타입과 관계를 정의하는 언어입니다.
- SHACL(Shapes Constraint Language): 데이터가 정해 둔 규칙을 지키는지 검사하는 언어입니다.
- SPARQL(SPARQL Protocol and RDF Query Language): 그래프에서 필요한 정보를 조회하는 쿼리 언어입니다. 이름 안에 자기 이름이 다시 들어가는 약어이며, "스파클"이라고 읽습니다.
Netflix는 이 가운데 RDF, OWL, SHACL, SPARQL로 온톨로지를 구성하고, 데이터는 Turtle 형식으로 보관합니다. IRI는 RDF에 포함된 개념이지만, 처음 접하면 낯설 수 있어서 따로 설명합니다.
왜 RDF로 데이터를 표현할까요
데이터를 표현하는 방법에는 RDF 말고도 관계형 데이터베이스의 테이블이나 JSON 같은 문서 형식이 있습니다. 세 방식이 여러 도구의 데이터를 다룰 때 어떻게 다른지 비교하면 다음과 같습니다.
| 비교 항목 | 관계형 테이블 | JSON 문서 | RDF |
|---|---|---|---|
| 데이터의 구조 | 테이블마다 정해진 컬럼 | 도구(배포 도구, 알림 도구 등)마다 따로 정한 필드 이름과 중첩 구조 | 모든 사실을 주어·관계·목적어 세 부분으로 적은 한 줄(트리플) |
| 새로운 종류의 관계를 추가할 때 | 스키마를 바꿔 컬럼이나 테이블을 추가 | 스키마 변경 없이 문서에 필드를 추가 | 스키마 변경 없이 새 관계로 한 줄 추가 |
| 여러 출처의 데이터를 합칠 때 | 공통 키를 맞춘 뒤 조인 | 도구마다 필드와 값을 맞추는 변환 코드 작성 | 같은 이름을 쓰면 그대로 연결 |
| 대상의 이름 | 데이터베이스 안에서만 유효한 기본 키 | 도구마다 다르게 적은 문자열 | 어디서나 고유한 IRI |
JSON은 형식이 자유로워서 필드 이름과 구조를 도구마다 다르게 정할 수 있습니다. 앞의 게이트웨이 예시에서도 세 도구가 같은 게이트웨이를 각각 application, service, affected_cluster 필드에 적었고, 값도 apigateway, api-gateway-prod, api-gw-useast1로 모두 달랐습니다.
필드의 위치가 다를 수도 있습니다. 아래 두 기록은 같은 서비스 이름을 담고 있습니다.
# 도구 A
{ "service": "api-gateway-prod" }

# 도구 B
{ "target": { "service": { "name": "api-gateway-prod" } } }
도구 A에서는 service 필드를 바로 읽으면 되지만, 도구 B에서는 target 안의 service 안에 있는 name까지 찾아 들어가야 합니다.
그래서 여러 도구의 기록을 합치려면, 도구마다 다른 필드 이름과 위치를 동일한 형태로 바꿔 주는 코드가 필요합니다. RDF에서는 모든 데이터를 처음부터 주어, 관계, 목적어라는 한 가지 형태로 적습니다. 그래서 같은 대상을 같은 이름으로 부르기만 하면, 출처가 다른 데이터도 따로 맞춰 줄 필요 없이 바로 연결됩니다.
Netflix에 필요했던 것도 바로 이것입니다. 구조와 이름이 제각각인 여러 도구의 데이터를 서로 연결해야 했고, 이런 일에는 RDF가 잘 맞습니다. RDF와 함께 쓰는 타입 정의(OWL), 검증(SHACL), 조회(SPARQL) 표준도 이미 있습니다.
1. RDF: 사실을 주어, 관계, 목적어로 기록하는 방식
RDF에서는 모든 사실을 주어, 관계, 목적어의 세 부분으로 나누어 기록하고, 이렇게 기록한 한 줄을 트리플이라고 부릅니다. 예를 들어 "api-gateway는 Team Bedrock이 담당한다"라는 사실에서는 api-gateway가 주어, 담당한다는 뜻의 ownedBy가 관계, Team Bedrock이 목적어가 됩니다. RDF 명세에서는 이 관계에 해당하는 부분을 술어(predicate)라고 부릅니다. 아래는 Netflix가 소개한 예시입니다.
api-gateway   rdf:type       ops:Application .
api-gateway   ops:ownedBy    "Team Bedrock" .
api-gateway   ops:deployedIn "us-east-1" .

INC-5377      rdf:type       ops:Incident .
INC-5377      ops:affects    api-gateway .
INC-5377      ops:severity   "SEV 2" .
위 예시는 총 여섯 줄이고 한 줄이 정보 하나를 나타냅니다. 각 줄 끝의 마침표(.)는 트리플 하나가 끝났다는 표시입니다. 이 여섯 줄에 담긴 정보는 원래 서로 다른 도구에 흩어져 있었습니다. 담당 팀은 소프트웨어 카탈로그에, 배포된 리전은 Spinnaker에, 장애 정보는 장애 관리 도구에 있었습니다. 트리플로 바꾸면 출처가 다른 정보도 모두 같은 형식으로 만들어지기 때문에, 한 그래프에 모을 수 있습니다. 그래프에서 주어와 목적어는 점(노드)이 되고, 관계는 두 점을 잇는 선(엣지)이 됩니다.
왜 필요할까요
앞에서 본 도구별 JSON 기록과 트리플을 비교하면 차이가 분명해집니다.
| 원래 기록 (도구별 JSON) | 트리플 |
|---|---|
배포 도구: "application": "apigateway", "region": "us-east-1" | api-gateway ops:deployedIn "us-east-1" . |
장애 관리 도구: "affected_cluster": "api-gw-useast1" | INC-5377 ops:affects api-gateway . |
장애 관리 도구: "severity": "SEV 2" | INC-5377 ops:severity "SEV 2" . |
JSON 기록은 도구마다 필드 이름과 구조가 다르기 때문에, 두 도구의 데이터를 합치려면 한쪽 구조를 다른 쪽 구조로 바꾸는 변환 코드가 필요합니다. 연결할 도구가 늘어날수록 이런 변환 코드도 함께 늘어납니다. 반면 트리플은 어느 도구에서 왔든 형태가 같습니다. 예를 들어 온콜 도구를 새로 연결한다면, 그 도구의 기록을 트리플로 바꿔 아래처럼 한 줄 추가하기만 하면 됩니다. 여기서 ex:는 설명을 위해 지어낸 이름입니다.
# 온콜 도구의 원래 기록
{ "service_id": "PGW01", "escalation_policy": "gateway-oncall" }

# 트리플로 바꾼 기록
api-gateway   ex:onCallRotation   "gateway-oncall" .
2. IRI와 접두사: 이름이 겹치지 않게 하는 방법
RDF에서는 대상과 관계의 이름을 웹 주소와 비슷한 형태의 전체 식별자(IRI)로 적습니다. 예시에 나온 rdf:type, ops:Application에서 콜론 앞에 붙은 부분은 접두사입니다. 매번 전체 주소를 쓰기는 번거롭기 때문에, 앞부분을 접두사로 줄여서 씁니다. 예를 들어 rdf:type은 http://www.w3.org/1999/02/22-rdf-syntax-ns#type을 줄인 표기이고, "이 대상의 타입은 무엇이다"라는 의미로 W3C가 미리 정의해 둔 관계입니다.
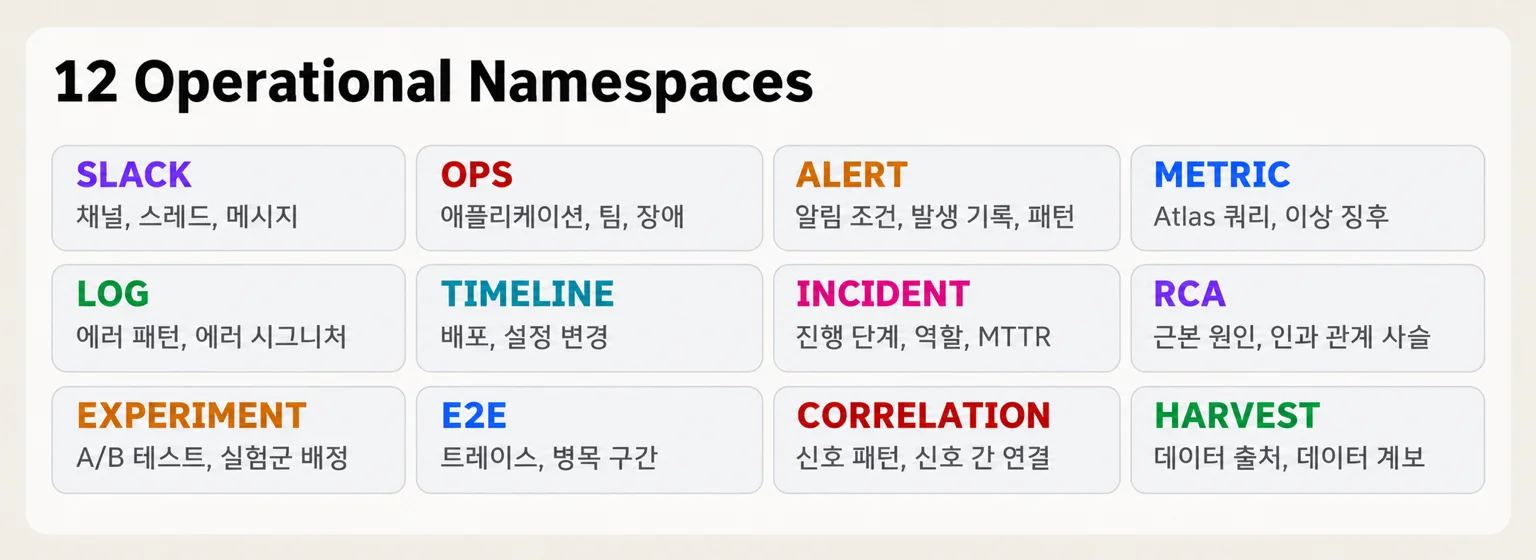
같은 접두사 아래에 묶인 이름의 집합을 네임스페이스라고 부릅니다. Netflix의 온톨로지는 운영 도메인을 하나씩 담당하는 열두 개의 네임스페이스로 구성되어 있습니다.
왜 필요할까요
이름을 단순한 문자열로만 다루면 두 기록이 같은 대상의 기록인지 문자열을 비교해서 판단해야 합니다. 예를 들어 apigateway, api-gateway-prod, api-gw-useast1이 같은 서비스인지 확인하려면, 아래처럼 이름을 비교하는 함수를 따로 만들어야 합니다.
def same_service(a, b):
    def normalize(name):
        return name.lower().replace("-prod", "").replace("gw", "gateway").replace("-", "")
    return normalize(a) == normalize(b)

same_service("apigateway", "api-gateway-prod")  # True
same_service("apigateway", "api-gw-useast1")    # False: 리전 표기가 붙어 있어 놓칩니다
이런 규칙은 새로운 표기 방식이 나올 때마다 늘어나고, 그래도 빠지는 경우가 생깁니다.
다만, IRI를 쓴다고 이 문제가 저절로 해결되지는 않습니다. 데이터를 넣을 때 app:api-gateway 대신 app:api-gateway-prod를 적으면, 그래프에는 서로 다른 대상 두 개가 생깁니다. 이 경우에는 RDF는 두 IRI가 같은 대상인지 알지 못합니다.
그래서 Netflix는 데이터를 그래프에 저장하기 전에 이름을 확인합니다. 이때 소프트웨어 카탈로그를 기준으로 삼습니다. 소프트웨어 카탈로그는 회사의 애플리케이션 이름과 식별자를 모아 둔 목록입니다. 새 애플리케이션 정보가 들어오면 카탈로그에서 그 이름을 찾아 등록된 식별자로 저장하고, 카탈로그에서 찾을 수 없는 이름은 애플리케이션으로 저장하지 않습니다. 그러면 그래프 안에서는 같은 애플리케이션이 항상 같은 식별자로 적히므로, 앞의 same_service 같은 함수로 이름을 비교할 필요가 없습니다.
# 배포 도구의 기록
app:api-gateway   ops:deployedIn   "us-east-1" .

# 장애 관리 도구의 기록
inc:INC-5377      ops:affects      app:api-gateway .
두 기록 모두 app:api-gateway라는 같은 식별자를 쓰므로, 따로 비교하지 않아도 같은 게이트웨이의 기록이라는 것을 바로 알 수 있습니다. 카탈로그와 대조하는 과정은 뒤에서 다시 다룹니다.
3. Turtle: RDF를 텍스트 파일로 기록하는 문법
RDF는 데이터를 어떤 구조로 표현할지를 정한 모델입니다. 따라서 실제로 파일에 저장하려면 별도의 문법이 필요하며, Turtle은 그중에서 사람이 읽기 쉬운 텍스트 문법입니다. 앞의 예시는 설명하기 쉽도록 간략하게 적은 것입니다. 이를 Turtle 문법에 맞춰 다시 쓰면 다음과 같습니다.
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .
@prefix ops: <https://example.com/ops#> .
@prefix app: <https://example.com/app/> .
@prefix inc: <https://example.com/incident/> .

app:api-gateway  rdf:type        ops:Application ;
                 ops:ownedBy     "Team Bedrock" ;
                 ops:deployedIn  "us-east-1" .

inc:INC-5377     rdf:type        ops:Incident ;
                 ops:affects     app:api-gateway ;
                 ops:severity    "SEV 2" .
@prefix로 시작하는 줄에서는 접두사를 선언하고, 각 트리플은 마침표(.)로 끝냅니다. 세미콜론(;)은 앞 줄과 같은 주어로 이어서 적는다는 뜻이므로, 주어를 반복해서 쓰지 않아도 됩니다. 따옴표로 감싼 값은 문자열이고, 접두사가 붙은 값은 다른 대상을 가리키는 이름입니다. 예를 들어 inc:INC-5377의 ops:affects 값이 app:api-gateway이므로, 그래프에서는 두 대상이 선으로 연결됩니다.
Netflix는 데이터를 수집할 때마다 전체 그래프를 Turtle 파일로 직렬화해 따로 남겨 둡니다. 에이전트가 실제로 조회하는 그래프는 뒤에서 설명할 그래프 저장소에 있고, Turtle 파일은 그 그래프를 텍스트 파일로 만든 사본입니다. 이 사본은 사람이 직접 읽을 수 있고 diff로 비교할 수도 있어서, 디버깅에 예상보다 훨씬 유용합니다.
왜 필요할까요
그래프가 저장소 안에만 있으면 이전과 무엇이 바뀌었는지 확인하기 위해 두 시점의 데이터를 각각 조회해서 직접 비교해야 합니다. 반면 시점마다 Turtle 파일을 남겨 두면, 두 파일을 diff로 비교해 바뀐 부분을 바로 볼 수 있고, 파일이 쌓이는 것만으로 변경 이력도 남습니다. 조회는 저장소에서 하고, 변경 확인은 파일로 하면 됩니다.
RDF를 텍스트로 적는 형식에는 태그가 많은 RDF/XML 같은 형식도 있지만, Turtle은 사실 하나를 일반적으로 한 줄에 적습니다. 그래서 가령 api-gateway의 담당 팀이 바뀌면 diff에서도 그 한 줄만 바뀐 것으로 나타납니다.
 app:api-gateway  rdf:type        ops:Application ;
-                 ops:ownedBy     "Team Bedrock" ;
+                 ops:ownedBy     "Team Edge" ;
                  ops:deployedIn  "us-east-1" .
다만 diff가 이렇게 깔끔하게 나오려면, 파일로 만들 때마다 트리플을 항상 같은 순서로 적어야 합니다. 순서까지 맞춰 두면 코드 변경을 리뷰하듯이 그래프의 변경도 확인할 수 있습니다.
4. OWL: 사용할 수 있는 타입과 관계를 정의하는 언어
지금까지 본 트리플에서는 ops:ownedBy나 ops:deployedIn 같은 단어를 관계 이름으로 썼습니다. 그런데 RDF에는 어떤 단어를 써야 하는지 정하는 규칙이 없어서, 누군가는 ownedBy 대신 owner나 team이라고 적을 수도 있습니다. OWL은 이렇게 쓸 수 있는 단어를 미리 정의해 두는 언어입니다. OWL로는 어떤 타입(클래스)이 존재하는지, 그리고 어떤 관계(속성)가 어느 타입과 어느 타입을 연결하는지를 정의합니다. OWL로 작성한 정의도 결국 RDF 트리플이므로 Turtle 문법으로 적을 수 있습니다.
ops:Application  rdf:type  owl:Class .
ops:Incident     rdf:type  owl:Class .

ops:affects      rdf:type     owl:ObjectProperty ;
                 rdfs:domain  ops:Incident ;
                 rdfs:range   ops:Application .
이 정의는 "Application(애플리케이션)과 Incident(장애)는 타입이고, affects는 장애에서 애플리케이션으로 향하는 관계이다"라는 뜻입니다. 이렇게 정의해 두면 사람과 에이전트, 그리고 여러 도구가 같은 어휘를 기준으로 데이터를 기록하고 읽을 수 있습니다. 이러한 정의가 개념에 해당하고, app:api-gateway처럼 특정한 대상에 관한 트리플은 인스턴스에 해당합니다.
왜 필요할까요
공통으로 쓸 어휘가 정해져 있지 않으면 그래프에 데이터를 넣는 팀마다 같은 관계를 서로 다른 단어로 기록하게 됩니다.
# A 팀이 넣은 데이터
api-gateway   ex:ownedBy   "Team Bedrock" .

# B 팀이 넣은 데이터
api-gateway   ex:owner     "Team Bedrock" .

# C 팀이 넣은 데이터
api-gateway   ex:team      "Team Bedrock" .
세 줄은 모두 같은 사실을 담고 있습니다. 하지만 애플리케이션의 담당 팀을 조회할 때는 ex:ownedBy, ex:owner, ex:team을 모두 조건에 넣어야 합니다. 셋 중 하나라도 빠뜨리면 그 단어로 기록한 팀의 데이터는 조회 결과에 나오지 않습니다. 이렇게 되면 도구마다 이름이 달라서 생겼던 문제가 그래프 안에서 동일하게 나타납니다.
OWL로 공식 어휘를 정의해 두면 데이터를 넣는 팀은 새 단어를 만들지 않고 이미 정의된 ops:ownedBy를 찾아 쓸 수 있습니다. 다만 OWL은 정의되지 않은 단어를 쓰지 못하게 막지는 않습니다. 그런 검사는 다음 섹션에서 다룰 SHACL이 맡습니다.
5. SHACL: 데이터가 규칙을 지키는지 검사하는 언어
OWL로 정의를 만들어 두어도 잘못된 데이터가 들어오는 것을 막을 수는 없습니다. 예를 들어 담당 팀 정보가 빠진 애플리케이션이 들어오더라도, OWL은 이를 아직 알려지지 않은 정보로 간주할 뿐 오류로 처리하지 않습니다. 오히려 ops:affects 관계가 붙은 대상을 발견하면, 위에서 작성한 정의에 따라 그 대상을 장애(Incident 타입)로 추론합니다.
데이터를 실제로 검사하는 경우에는 SHACL을 사용합니다. SHACL에서는 "이 타입의 대상에는 이 속성이 반드시 하나 있어야 한다"와 같이 데이터가 갖춰야 할 형태(Shape)를 정의하고, 실제 데이터가 그 형태를 따르는지 확인합니다. 즉, OWL은 단어의 의미를 정의하고, SHACL은 입력된 데이터를 검사합니다.
JSON Schema에 익숙하다면 SHACL을 그래프용 JSON Schema로 생각해도 됩니다. 다만 JSON Schema가 문서 하나의 구조를 검사한다면, SHACL은 그래프에서 특정 타입의 노드를 골라 검사하고, 그 노드가 가리키는 다른 노드의 타입까지 확인할 수 있습니다.
왜 필요할까요
검사 규칙을 한곳에 모아 두지 않으면, 데이터를 넣을 때마다 검증 코드를 추가로 넣어야 합니다.
# 배포 기록을 넣는 스크립트: 담당 팀이 없으면 경고만 남깁니다
if "team" not in record:
    log.warning("team missing: %s", record["application"])

# 장애 기록을 넣는 스크립트: 검증 코드가 없습니다
graph.add(to_triples(record))
이렇게 되면 검증 코드가 없는 스크립트로 들어온 데이터는, 담당 팀이 없더라도 아무 경고 없이 그래프에 쌓입니다. SHACL을 사용하면 규칙을 한 번만 선언해 두고, 어느 스크립트로 들어온 데이터든 같은 기준으로 검사할 수 있습니다. 아래 Shape는 "모든 애플리케이션에는 담당 팀이 하나 이상 있어야 한다"는 규칙을 적은 예시입니다.
ex:ApplicationShape
    rdf:type sh:NodeShape ;
    sh:targetClass ops:Application ;
    sh:property [
        sh:path ops:ownedBy ;
        sh:minCount 1 ;
    ] .
SHACL은 명세이므로, 실제 검사는 SHACL을 구현한 라이브러리가 맡습니다. 예를 들어 Python에서는 pySHACL로 이렇게 검사할 수 있습니다. data.ttl에는 담당 팀이 있는 app:api-gateway와 담당 팀이 빠진 app:billing을 넣고, shapes.ttl에는 위 Shape를 넣었습니다.
from rdflib import Graph
from pyshacl import validate

data = Graph().parse("data.ttl")
shapes = Graph().parse("shapes.ttl")

conforms, report_graph, report_text = validate(data, shacl_graph=shapes)
print(report_text)
Validation Report
Conforms: False
Results (1):
Constraint Violation in MinCountConstraintComponent:
	Focus Node: app:billing
	Result Path: ops:ownedBy
	Message: Less than 1 values on app:billing->ops:ownedBy
sh:targetClass가 그래프에서 ops:Application 타입인 노드를 모두 고르고, 각 노드에 ops:ownedBy 값이 몇 개인지 셉니다. 그 결과 담당 팀이 없는 app:billing만 위반으로 보고됩니다. 검증 보고서(report_graph)도 RDF 그래프로 나오므로, 위반 내역을 다른 데이터처럼 SPARQL로 조회할 수 있습니다. Java에서는 Apache Jena나 RDF4J가 SHACL을 지원하고, 여러 RDF 데이터베이스도 SHACL 검증 기능을 내장하고 있습니다.
6. SPARQL: 그래프를 조회하는 쿼리 언어
SPARQL은 RDF 그래프를 조회하는 쿼리 언어입니다. SQL이 테이블에서 조건에 맞는 행을 찾는다면, SPARQL은 트리플 형태의 패턴을 작성한 뒤 그 패턴과 일치하는 값을 찾습니다.
아래 쿼리에서 물음표로 시작하는 ?app과 ?incident는 아직 알지 못하는 값을 담는 변수입니다. 예를 들어 "us-east-1에서 Team Bedrock이 담당하는 애플리케이션에 영향을 준 장애는 무엇인가?"라는 질문을 SPARQL로 옮기면 다음과 같습니다(접두사 선언은 생략했습니다).
SELECT ?incident WHERE {
  ?app      rdf:type       ops:Application ;
            ops:ownedBy    "Team Bedrock" ;
            ops:deployedIn "us-east-1" .
  ?incident rdf:type       ops:Incident ;
            ops:affects    ?app .
}
앞의 Turtle 예시 데이터에 이 쿼리를 실행하면 다음 결과가 나옵니다.
| incident     |
| ------------ |
| inc:INC-5377 |
어떻게 이 결과가 나오는지 순서대로 보자면, 먼저 타입이 ops:Application이고, 담당 팀이 "Team Bedrock"이며, us-east-1에 배포된 대상을 찾습니다. 그래프에서 세 조건을 모두 만족하는 대상은 app:api-gateway 하나이므로 ?app에는 이 값이 들어갑니다. 다음으로 타입이 ops:Incident이고 app:api-gateway에 영향을 준 대상을 찾으면 inc:INC-5377이 나옵니다. 조건에 맞는 장애가 여러 개라면 결과도 그만큼 여러 행으로 나옵니다.
SPARQL도 명세이므로 쿼리는 이를 구현한 라이브러리나 데이터베이스가 실행합니다. 예를 들어 Python의 rdflib에서는 앞의 Turtle 예시를 graph.ttl로 저장해 두고 다음처럼 실행할 수 있습니다. query에는 위 쿼리 문자열이 들어 있습니다.
from rdflib import Graph

graph = Graph().parse("graph.ttl")

for row in graph.query(query):
    print(row.incident)  # https://example.com/incident/INC-5377
rdflib은 파일에 선언된 접두사를 쿼리에도 그대로 적용하므로, 쿼리에서 접두사 선언을 생략해도 됩니다. 데이터가 커지면 Apache Jena Fuseki 같은 SPARQL 서버나 RDF 데이터베이스에 같은 쿼리를 보내 실행합니다.
왜 필요할까요
온톨로지가 없을 때 같은 질문에 답하려면, 세 도구를 각각 조회한 뒤 그 결과를 코드에서 직접 이어 붙여야 합니다. 아래는 그 과정을 보여 주는 가상의 코드입니다.
apps = [a for a in catalog.list_apps() if a.owner_team == "Team Bedrock"]
in_region = [a for a in apps if "us-east-1" in deploy_tool.regions(a.name)]
names = {normalize(a.name) for a in in_region}
incidents = [i for i in incident_tool.list_incidents()
             if normalize(i.affected_cluster) in names]
이 코드는 도구마다 다른 API를 알아야 하고, 이름을 비교하는 normalize 같은 규칙에도 의존합니다. 질문이 조금만 바뀌어도 코드를 다시 작성해야 합니다. 모든 사실이 같은 형태의 트리플로 한 그래프에 모여 있으면, 질문을 위와 같은 쿼리로 옮기기만 하면 됩니다.
자체 형식 대신 표준을 고른 이유
가장 큰 이유는 다른 곳으로 쉽게 옮길 수 있기 때문입니다. RDF, OWL, SHACL, SPARQL은 명세가 공개되어 있고 여러 구현체가 존재하기 때문에, 모델을 여러 그래프 저장소로 옮겨 가며 사용할 수 있습니다. 반면 자체 그래프 모델을 사용하면, 이후에 그 그래프를 사용하는 사람들이 특정 구현에 묶이게 됩니다.
그래프를 저장하는 저장소는 여러 가지가 있는데, Netflix는 QuipuDB라는 그래프 저장소를 직접 만들어 씁니다. QuipuDB는 데이터를 여러 서버에 나눠 저장하고, 트리플을 쿼드라는 형태로 저장합니다. 쿼드는 트리플에 "이 사실이 어느 그래프에 속하는가"라는 정보를 하나 더 붙인 것입니다. 세 부분(트리플)에 하나를 더해 네 부분(쿼드)이 된다는 뜻에서 붙은 이름입니다.
QuipuDB는 트리플과 쿼드를 이해하고 데이터를 여러 서버에 나눠 관리하는 상위 계층입니다. redb는 그 아래에서 각 서버의 디스크에 데이터를 실제로 쓰고 읽는 일을 맡습니다. redb는 Rust로 만든 가벼운 데이터베이스로, 별도의 서버 없이 프로그램 안에 넣어서 쓰고 데이터를 키와 값의 짝으로만 저장합니다. redb는 그래프가 무엇인지는 알지 못합니다. 이와 같이 단순한 저장 엔진 위에 데이터베이스를 쌓는 방식은 흔히 쓰입니다. 예를 들어 CockroachDB도 Pebble이라는 키-값 저장 엔진 위에 만들어졌습니다.
저장소는 다양한 형태로 있을 수 있지만, 그 안에 담는 데이터와 온톨로지는 표준을 따릅니다. 그래서 나중에 저장소를 바꾸더라도 데이터를 그대로 옮길 수 있습니다. Turtle 파일을 읽어 들이는 도구, SHACL 규칙으로 데이터를 검사하는 도구, SPARQL 쿼리를 실행하는 도구처럼 이미 공개된 도구도 그대로 가져다 쓸 수 있습니다.
성능은 어떨까요? 데이터를 온톨로지와 그래프로 정리하면 에이전트가 더 정확하게 답한다는 연구는 있습니다. 하지만 RDF 표준이 다른 그래프 방식보다 성능이 낫다는 근거는 아직 없습니다. 그래서 Netflix가 RDF 표준을 고른 것도 성능보다는 다른 제품으로 옮기기 쉽고 이미 갖춰진 도구가 많기 때문으로 보는 편이 맞습니다. 직접 도입을 검토한다면 골든셋을 만들어 지금 방식과 비교해 보는 것이 가장 확실한 근거가 됩니다.
에이전트가 믿고 쓸 수 있는 그래프 만들기
표준을 갖췄다고 해서 에이전트가 믿고 쓸 수 있는 그래프가 저절로 만들어지지는 않습니다. Netflix 사례에서 얻을 수 있는 원칙을 네 가지로 정리하면 다음과 같습니다.
1. 같은 애플리케이션의 기록인지부터 확인합니다
처음부터 서로 다른 애플리케이션을 같은 애플리케이션으로 잘못 묶으면, 그 뒤에 하는 작업도 모두 틀리게 됩니다. 그래서 Netflix는 데이터를 등록할 때 다음 세 가지 규칙을 지킵니다.
- 범용 Service 타입을 두지 않습니다. Netflix의 도구들은 같은 대상을 애플리케이션, 서비스, 클러스터처럼 서로 다른 이름으로 부르고, "서비스"라는 말도 도구마다 가리키는 대상이 달랐습니다. 이 말을 그대로 Service 타입으로 만들면 성격이 다른 대상이 한 타입에 섞여, 서로 다른 기록이 잘못 연결되기 쉽습니다. 그래서 Netflix는 소프트웨어 카탈로그에 등록된 애플리케이션만
ops:Application으로 표현합니다. 이는 Netflix의 도구 환경에 맞춘 결정이므로, 용어가 일관되게 쓰이는 조직이라면 서비스 타입을 따로 두어도 괜찮습니다. - 카탈로그에 있는 이름만 등록합니다. 약 4만 9천 개의 항목이 있는 소프트웨어 카탈로그와 대조해서, 사용자 이름이나 팀 이름처럼 검증되지 않은 문자열은 애플리케이션으로 등록하지 않습니다.
- 의존 관계의 수에 상한을 둡니다. 많이 쓰이는 애플리케이션은 자신을 호출하는 다른 애플리케이션이 수천 개씩 생길 수 있어서, 상한이 없으면 그 애플리케이션 하나가 그래프의 대부분을 차지하게 됩니다.
또한 그래프에 담기는 정보를 두 종류로 나눠서 관리합니다.
| 구분 | 내용 | 예시 | 변경 빈도 |
|---|---|---|---|
| 개념 | 무엇을 어떻게 기록할지 미리 정해 둔 규칙(앞의 OWL 소절에서 본 정의) | "애플리케이션에는 담당 팀이 있다" | 드묾. 바꾸려면 검토와 합의가 필요함 |
| 인스턴스 | 실제 대상 하나하나에 대한 기록 | "api-gateway의 담당 팀은 Team Bedrock이다" | 잦음. 배포나 장애가 생길 때마다 들어옴 |
개념과 인스턴스로 분리하면 규칙은 안정적으로 유지하면서 자주 바뀌는 기록만 계속 갱신할 수 있습니다.
2. 결론과 근거를 함께 남깁니다
예를 들어, 장애 분석에는 원인과 해결책 외에도 남겨 둘 만한 내용이 있습니다.
- 담당자가 어떤 지표를 보고 연결 풀을 의심하게 되었는지
- 다른 하위 서비스가 지연되었을 가능성은 어떤 근거로 배제했는지
- 롤백한 뒤 어떤 지표가 회복되었는지
이런 과정은 로그와 메트릭 뿐만 아니라, 사람들이 나눈 대화까지 봐야 하는 경우가 많습니다.
Netflix는 이러한 대화도 그래프에 넣습니다. 예를 들어 메시지 200개, 참여자 50명, 관련 서비스 15개로 이루어진 장애 대응용 Slack 채널을 트리플로 바꿉니다. 이런 대화에는 다음과 같은 내용이 담겨 있습니다.
- 어떤 가설을 시도했다가 버렸는지
- 어떤 완화 조치가 효과가 있었는지
- 누가 무엇을 어떤 이유로 알고 있었는지
대화가 끝나면 이런 내용은 다시 찾기 어렵기 때문에 그래프에 남겨 둡니다. 실제로 그래프에서 가장 쓸모 있었던 연결(엣지)도 이런 논의에서 나왔습니다.
가설의 근거와 신뢰도는 Netflix의 상관관계 엔진(correlation engine)이 함께 기록합니다. 상관관계 엔진은 장애 무렵에 일어난 여러 이벤트 가운데 서로 관련이 있어 보이는 것들을 찾아서 이어 주는 시스템입니다. Datadog의 Watchdog RCA나 Dynatrace의 Davis AI처럼, 여러 신호를 엮어 장애 원인 후보를 보여 주는 상용 기능을 떠올리면 이해하기 쉽습니다.
엔진은 "배포를 했는데 그 뒤에 로그 오류가 늘었다"처럼 차례로 이어지는 이벤트의 흐름을 찾는데, 이 흐름을 체인이라고 부릅니다. 엔진이 체인을 찾고 평가하는 방식은 다음과 같습니다.
| 항목 | 내용 |
|---|---|
| 신호 | 로그 오류, 메트릭 이상, 느리거나 실패한 트레이스, 알림, 배포, 설정 변경, 실험, 커밋 등 열세 가지 |
| 가중치 | 로그 오류보다 먼저 일어난 배포나, 메트릭 이상보다 먼저 일어난 설정 변경처럼 원인과 결과의 순서가 이미 알려진 조합에 처음부터 높은 가중치를 줌 |
| 점수 | 10분 범위 안에서 이벤트가 얼마나 가까운 시간에 일어났는지와 심각도를 기준으로 매김 |
| Cutoff | 신뢰도 0.6 미만인 체인은 버리고, 0.87처럼 높은 체인은 사람이나 에이전트가 확인해 볼 만한 유력한 가설로 다룸 |
| 저장 | 체인을 만드는 데 사용한 그래프 레코드도 함께 저장함 |
그래서 그래프에는 결론뿐 아니라 그 결론을 뒷받침한 증거까지 가설과 함께 남습니다.
앞의 게이트웨이 사례를 Netflix의 표기 방식에 맞춰 예시로 적으면 다음과 같습니다. 이 중 Netflix가 실제로 사용하는 이름은 ops: 접두사가 붙은 것뿐이고, ex:로 시작하는 이름은 설명을 위해 예시로 만들어낸 것입니다.
ex:INC-4120  rdf:type       ops:Incident ;
             ops:affects    ex:api-gateway ;
             ex:region      "us-east-1", "eu-west-1" ;
             ex:deployedVersion "2024.10.3" .

ex:hyp-1     rdf:type       ex:Hypothesis ;
             ex:about       ex:INC-4120 ;
             ex:summary     "연결 풀 최대 크기 축소" ;
             ex:status      "confirmed" ;
             ex:evidence    <https://slack.example.com/archives/C01/p1001> .

ex:hyp-2     rdf:type       ex:Hypothesis ;
             ex:about       ex:INC-4120 ;
             ex:summary     "하위 서비스 응답 지연" ;
             ex:status      "ruled-out" ;
             ex:evidence    <https://metrics.example.com/d/downstream-p99> .
이 예시에는 당시의 배포 버전과 영향을 받은 리전, 그리고 사람이 확인한 원인과 배제한 가설이 각각의 근거 링크와 함께 기록되어 있습니다. 논의의 원본 메시지와 관측 기록으로 가는 링크를 붙여 두면, 에이전트가 요약 내용의 근거를 직접 다시 확인할 수 있습니다. 모든 대화를 통째로 넘기는 대신 관련된 내용만 추려서 전달하고, 필요할 때 근거를 직접 열어 볼 수 있게 하는 방식입니다.
이제 이번 장애에서 확인한 내용을 옆에 함께 적어 둡니다.
| 항목 | 예전 장애(INC-4120) | 이번 장애 |
|---|---|---|
| 증상 | 게이트웨이 타임아웃 | 게이트웨이 타임아웃 |
| 영향 리전 | us-east-1, eu-west-1 | 한 리전 |
| 실행 중인 버전 | 2024.10.3 | 다른 버전 |
| 연결 풀 지표 | 원인으로 확인됨 | 아직 확인하지 못함 |
아직 확인하지 못한 항목도 이렇게 그대로 적어 둡니다. 이 정도만 알려 줘도 에이전트는 연결 대기 시간과 풀 사용량부터 조회하고, 문제가 없는 리전과 설정이 다른지도 확인할 수 있습니다. 예전 기록은 이번에도 롤백하면 된다는 답을 주려고 쓰는 것이 아닙니다. 다음에 무엇을 확인해야 할지를 결정하는데 씁니다.
3. 빠진 정보는 빠졌다고 알립니다
Netflix에서는 인리처(enricher)라는 작은 프로그램 수십 개가 그래프에 데이터를 넣습니다. 인리처는 각각 한 가지 일만 처리합니다. 어떤 인리처는 로그에서 오류 정보를 찾아 넣고, 어떤 인리처는 배포 이력을 찾아 넣습니다. 이 인리처들은 정해진 순서에 따라 하나씩 실행됩니다. 그래서 뒤에 실행되는 인리처는 앞에서 넣어 둔 내용을 바탕으로 일할 수 있습니다.
모든 인리처는 같은 틀을 따릅니다. 외부 시스템에서 정리되지 않은 데이터를 읽어 오고, 그 데이터를 분석한 뒤, 타입이 정해진 트리플로 그래프에 넣습니다. Netflix는 이 틀을 일부러 단순하게 정해 두었습니다. 코드로 보면 다음과 같습니다.
class Enricher:
    async def _enrich_async(self, ...):
        raw    = await self.fetch(...)      # 1. 노이즈가 섞인 입력 읽기
        result = self.analyze(raw)          # 2. 처리 (확률적일 수 있음)
        graph.add((uri, RDF.type, OPS.X))   # 3. 타입이 지정된 트리플 내보내기
        graph.add((uri, OPS.pred, Literal(result.value)))
        return EnrichmentResult(success=True, triples_added=count)
인리처가 그래프에 넣는 결과는 다음 세 가지 조건을 항상 지켜야 합니다.
- 그래프에 넣는 모든 대상에는 타입(
rdf:type)이 있어야 합니다. - 모든 대상의 이름(IRI)은 같은 규칙으로 지어야 합니다.
- 애플리케이션(
ops:Application)은 카탈로그에서 확인된 것만 만들 수 있습니다.
인리처 안에서는 LLM처럼 실행할 때마다 결과가 달라질 수 있는 방법을 써도 됩니다. 다만 그래프에 넣을 때는 이 세 조건을 반드시 통과해야 하므로, 그래프에 쌓이는 데이터의 형태는 늘 일정하게 유지됩니다.
인리처가 메트릭, 로그, 이벤트 같은 외부 시스템을 호출하다 보면 응답이 늦거나 실패할 때도 있습니다. Netflix는 이럴 때도 전체 작업을 멈추지 않고, 가져올 수 있는 데이터만으로 계속 진행합니다(best-effort). 외부 시스템 하나가 느리면 그래프에 들어가는 정보가 조금 줄어들 뿐, 그래프를 채우는 작업은 끝까지 진행됩니다. 이때 이번 장애와 관련된 배포 이력을 가져오지 못했다면, 에이전트에게 넘기는 자료에도 다음 두 가지를 적어 두어야 합니다.
- 조회에 실패했다는 사실
- 마지막으로 조회에 성공한 시각
그렇지 않으면 에이전트는 배포 기록을 가져오지 못한 것인지, 실제로 배포가 없었던 것인지 구분할 수 없습니다.
인리처를 실행하는 순서도 결과에 영향을 줍니다. Netflix는 인리처를 동시에 실행하지 않고 하나씩 차례로 실행합니다. 한 인리처가 그래프를 불러와 트리플을 추가하고 다시 저장하면, 그다음 인리처가 같은 과정을 이어 갑니다. 이렇게 하면 두 가지 이점이 있습니다.
- 경쟁 상태가 생기지 않습니다: 여러 인리처가 같은 그래프를 동시에 고치다가 서로의 결과를 덮어쓰는 경쟁 상태(race condition)를 피할 수 있습니다.
- 결과가 더 정확해집니다: 뒤의 인리처가 앞에서 넣은 결과를 활용할 수 있습니다.
병렬로 처리할 때보다 느려지기는 하지만, Netflix는 그만한 가치가 있다고 판단했습니다. 게이트웨이 사례라면, 먼저 이 기록이 어느 애플리케이션의 것인지 확정한 다음에 그 애플리케이션의 배포 기록과 지표를 연결하는 식입니다.
인리처 안에서는 LLM을 써도 됩니다. 인리처가 LLM을 쓰는 대표적인 경우는 Slack 대화처럼 사람이 자유롭게 쓴 글을 다룰 때입니다. 배포 기록이나 알림과 달리 대화에는 정해진 필드가 없어서, 어떤 스레드가 장애에 관한 것인지 단순한 질문인지를 규칙만으로 가려내기 어렵습니다. 그래서 인리처는 LLM에게 스레드를 읽고 분류하게 한 뒤, 그 결과를 그래프에 넣습니다.
이때 LLM이 마음대로 답하게 두면 같은 뜻이 "장애", "incident", "장애로 보임"처럼 여러 표현으로 나옵니다. 그러면 앞에서 본 이름 문제가 그래프 안에서 다시 생깁니다. 그래서 LLM이 내놓는 결과도 정해진 타입과 값으로 제한합니다. LLM은 어떤 문장이든 만들어 낼 수 있지만, 그래프에는 정해진 타입과 값에 맞는 트리플만 넣을 수 있습니다. Netflix는 여러 원칙 가운데 이 원칙을 가장 중요하게 지킵니다. 예를 들어 Slack 스레드를 분류할 때는 모델이 고를 수 있는 값이 다음처럼 미리 정해져 있습니다.
# 모델은 아래 값 중에서만 고를 수 있습니다
category  IN ["incident", "question", "discussion", "decision"]
sentiment IN ["positive", "neutral", "negative", "urgent"]

# 그래프에는 이렇게 들어갑니다
thread:123  slack:category          "incident" .
thread:123  slack:isIncidentRelated "true"^^xsd:boolean .
후보 중에서 고르는 일이라면? Slack 스레드 분류는 정해진 후보 가운데 하나를 고르는 일입니다. 2026년 가을부터는 이런 일에 맞춘 결정 모델(decision model)이 잇달아 나오고 있습니다. 결정 모델은 문장을 생성하지 않고, 호출하는 쪽이 정해 준 선택지마다 확률을 매깁니다. 답을 텍스트로 만들어 내지 않으므로 일반 LLM보다 빠르고 저렴하게 쓸 수 있고, 확률이 높은 결과는 그대로 그래프에 넣고 낮은 결과는 사람에게 넘기는 식으로 활용할 수 있습니다.
- Jev(TypeSafe AI, 2026년 9월): 이런 방식을 "System One Model"이라는 이름으로 처음 내놓은 모델입니다. TypeSafe가 제공하는 API로만 쓸 수 있고, 아직 얼리 액세스 단계입니다.
- Clef(Cloudflare, 2026년 10월): 가중치를 Apache 2.0 라이선스로 공개한 모델입니다. Workers AI에서 호출하거나 직접 내려받아 실행할 수 있고, 속도를 더 높인 Clef-flash도 함께 나왔습니다.
- Microsoft-Decision-1(Microsoft, 2026년 10월): Microsoft Foundry에서 쓸 수 있고, 선택지마다 보정된 확률을 돌려줍니다. 다만 왜 그렇게 판단했는지는 설명하지 않으므로, 근거가 필요하면 따로 남겨야 합니다.
- Gemini Decision 1(Google, 2026년 11월): Gemini API의 Decisions API로 쓰는 모델이고, Google AI Studio에서 바로 써 볼 수 있습니다. 같은 입력에 대한 질문을 한 번에 최대 1,000개까지 보낼 수 있고, 질문마다 고른 답과 0~1 사이의 확신도를 돌려줍니다.
인리처는 하나씩 차례로 실행되므로 한 단계가 빨라지면 전체 작업도 그만큼 빨리 끝나고, Slack 스레드처럼 양이 많은 데이터를 분류할수록 비용 차이도 커집니다.
LLM의 답을 정해진 값으로 제한한 것처럼, 그래프에 들어가는 내용도 형식을 정해 두고 제한할 수 있습니다. 그러면 필요한 정보가 빠진 기록을 그래프에 넣기 전에 걸러 낼 수 있습니다.
앞의 "2. 결론과 근거를 함께 남깁니다"에서 예시를 다시 보자면, 그 기록에는 장애 원인 후보, 즉 가설(ex:hyp-1, ex:hyp-2)마다 두 가지가 적혀 있었습니다. ex:status에는 그 가설이 "confirmed"(확인됨)인지 "ruled-out"(배제됨)인지를, ex:evidence에는 그렇게 판단한 근거 링크를 적었습니다. 이 두 가지가 제대로 적혀 있지 않으면 에이전트는 그 가설을 믿고 쓰기 어렵습니다. 예를 들면 다음과 같은 경우입니다.
- 확인됐는지 배제됐는지 적혀 있지 않은 가설
- "confirmed"와 "ruled-out"이 함께 적혀 있어서 어느 쪽인지 알 수 없는 가설
- 근거 링크가 하나도 없는 가설
이런 제대로 작성되지 않은 내용이 그래프에 들어가지 않도록 SHACL로 미리 검사할 수 있습니다.
검사 규칙을 Shape로 적으면 다음과 같습니다.
ex:HypothesisShape
    rdf:type sh:NodeShape ;
    sh:targetClass ex:Hypothesis ;
    sh:property [
        sh:path ex:status ;
        sh:in ( "confirmed" "investigating" "ruled-out" ) ;
        sh:minCount 1 ;
        sh:maxCount 1 ;
    ] ;
    sh:property [
        sh:path ex:evidence ;
        sh:minCount 1 ;
    ] .
Shape의 각 조건이 막는 문제는 다음과 같습니다.
| 조건 | 막는 문제 |
|---|---|
ex:status의 sh:in | 정해 둔 세 가지 외의 상태 값 |
ex:status의 sh:minCount 1, sh:maxCount 1 | 상태가 빠지거나 두 개 적힌 가설 |
ex:evidence의 sh:minCount 1 | 근거 링크가 하나도 없는 가설 |
다만 SHACL은 필요한 항목이 빠짐없이 들어 있는지만 확인할 뿐, 그 내용이 사실인지는 알지 못합니다. 원인 분석이 맞는지는 따로 확인해야 합니다.
표준을 따르더라도 RDF 데이터베이스마다 동작이 똑같지는 않습니다. 데이터는 다른 제품으로 그대로 옮길 수 있지만, 추론이나 검증 기능을 어디까지 지원하는지는 제품마다 다릅니다. 사용하는 데이터베이스를 바꿀 때는 이런 기능이 그대로 동작하는지 확인해 봐야 합니다.
4. 온톨로지를 바꿀 때도 코드처럼 리뷰합니다
온톨로지에는 판단 기준이 있습니다. 이름이 다른 두 기록을 같은 애플리케이션으로 볼지, 여러 가설 가운데 어떤 것을 장애 원인으로 인정할지 같은 기준입니다. 이런 기준을 하나만 바꿔도 에이전트에 넘기는 맥락이 달라집니다.
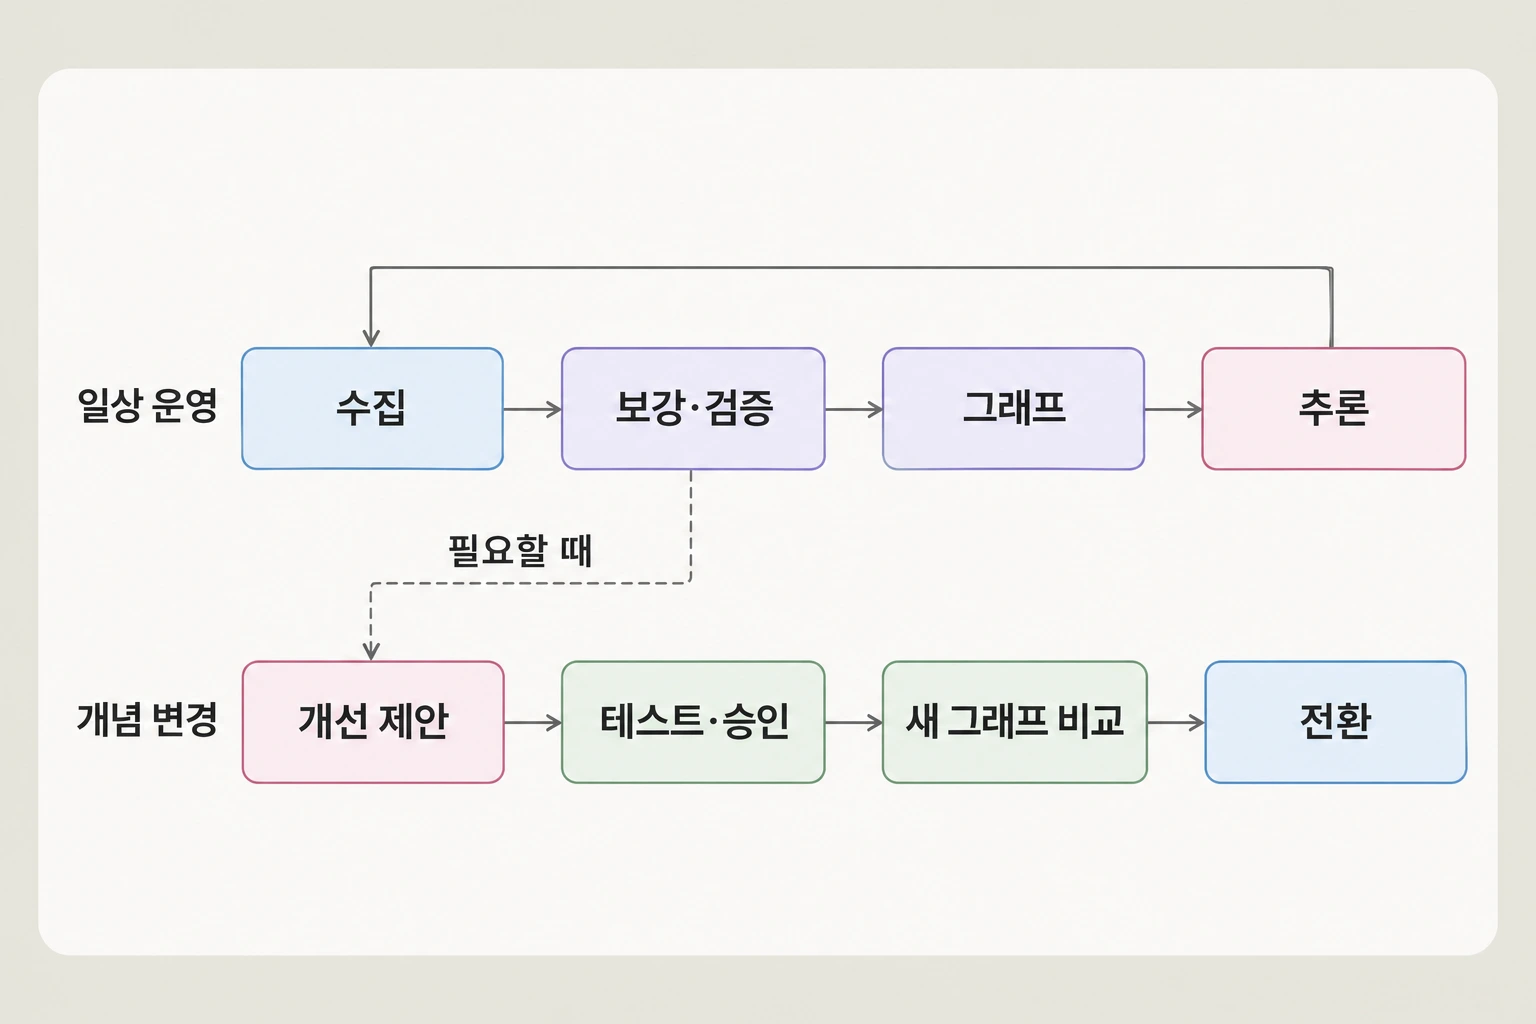
그래서 온톨로지도 코드처럼 다루는 편이 안전합니다. 버전을 관리하고, 바꿀 때는 테스트와 리뷰를 거친 PR로 반영합니다. 규칙을 고친 뒤에는 이미 정리해 둔 지난 장애 몇 건으로 자료를 다시 만들어 예전 자료와 비교합니다. 같은 애플리케이션으로 묶이던 기록이 갈라지지 않았는지, 확인된 원인으로 남아 있던 가설이 빠지지 않았는지를 보면 변경이 의도대로 동작하는지 알 수 있습니다. 이 비교를 어떻게 하는지는 뒤의 반영 단계에서 자세히 다룹니다.
온톨로지는 에이전트끼리 정보를 주고받는 약속이기도 합니다. Netflix의 AutoSRE는 대규모 분산 시스템의 장애 원인을 자동으로 분석하고 해결하기 위해 설계된 시스템으로, 각자 한 가지 분석을 맡은 여러 에이전트가 같은 그래프를 함께 씁니다. 트레이스를 분석하는 에이전트가 어떤 애플리케이션(ops:Application)에 대해 찾은 내용을 트리플로 적으면, 로그를 분석하는 에이전트가 그 트리플을 읽어 자기 분석에 씁니다.
두 에이전트는 서로를 몰라도 그래프만 보고 함께 일할 수 있습니다. 새 에이전트를 추가할 때도 그래프에서 쓰는 단어만 알면, 다른 에이전트가 적어 둔 내용을 바로 읽을 수 있습니다.
에이전트는 제안까지만 하고, 최종 결정은 사람이 내립니다. 다만 제안이 많아지면 사람이 모든 것을 하나하나 볼 수는 없으므로, 역할을 다음처럼 나눕니다.
| 담당 | 하는 일 |
|---|---|
| 에이전트 | 다음에 확인할 내용, 취할 조치, 인리처나 온톨로지를 바꿀 방법을 제안 |
| 자동 검사 | 필수 항목이 빠지지 않았는지, 식별자가 올바른지처럼 기계로 확인할 수 있는 부분을 검사 |
| 사람 | 근거가 충분한지, 실제로 조치했을 때 어떤 영향이 있을지 판단하고 최종 결정 |
사람이 판단한 내용을 기록할 때는 이번 장애에서 직접 확인한 것과 아직 짐작일 뿐인 것을 나눠 적습니다. 예전 분석이 틀렸거나 그사이 환경이 바뀌었다면 그 사실도 함께 남겨 둡니다.
온톨로지는 언제, 어떻게 바뀔까요
슬랙 장애 채널에 "장애가 발생한 이유가 배포 때문인 것 같습니다"라는 메시지가 올라왔다가, 10분 뒤에 "배포 전에도 같은 오류가 있었네요. 장애가 발생한 이유가 배포 때문은 아닌 것 같습니다"라는 정정이 올라왔다고 해 보겠습니다. 두 메시지를 그대로 쌓기만 하면, 에이전트는 서로 어긋나는 판단을 한꺼번에 읽게 됩니다. 그래서 그래프를 운영할 때는 새 사실을 넣는 것만큼이나 예전 판단을 언제 고치고 무엇을 기록으로 남길지 정하는 일이 중요합니다.
Netflix는 기술 블로그에서 이 과정을 관측(Observe), 보강(Enrich), 추론(Infer), 반영(Adapt) 이 되풀이되는 루프로 설명합니다. 발표에 따르면 새 메시지가 올라올 때마다 하베스터(harvester)라는 수집 작업이 돌고, 인리처가 그 메시지를 트리플로 바꿔 그래프에 넣습니다.
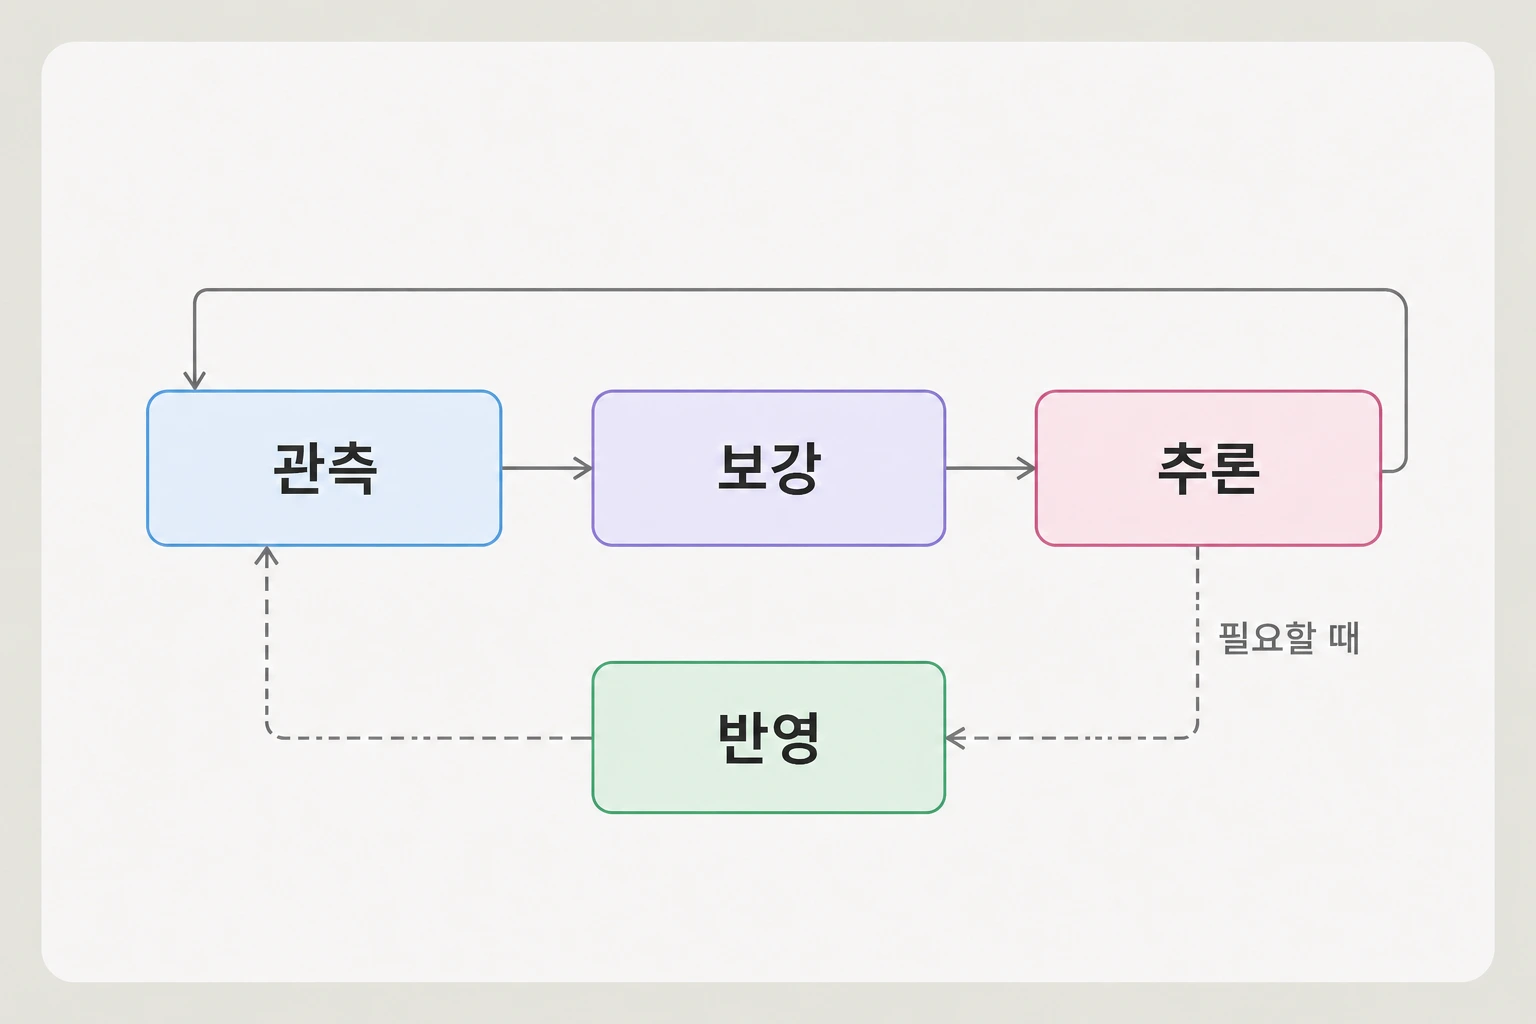
아래에서는 이 네 단계를 차례로 따라가 보겠습니다. 관측부터 추론까지는 온톨로지가 정한 개념에 맞춰 인스턴스가 쌓이고 바뀌는 과정이고, 개념 자체가 바뀌는 것은 마지막 반영 단계입니다. 각 단계의 세부 내용은 Netflix가 공개한 흐름에 일반적인 운영 방법을 더해 정리했습니다.
관측(Observe): 새로 올라오거나 바뀐 내용을 관측합니다
관측은 장애 채널에 올라오는 메시지처럼 새로 생기거나 바뀐 기록을 받아들이는 단계입니다. 관측 단계는 다음 세 가지로 구성합니다.
- 수신기: Slack의 이벤트 API처럼 메시지가 올라오거나 수정·삭제될 때 알려 주는 기능을 구독합니다.
- 큐: 받은 이벤트를 곧바로 처리하지 않고 쌓아 둡니다. 하베스터가 잠시 멈추거나 느려져도 이벤트를 잃지 않습니다. 같은 장애 채널의 이벤트를 순서대로 처리하도록 묶어 두면, 여러 작업이 같은 장애를 동시에 고치다 충돌하는 일도 막을 수 있습니다.
- 하베스터: 큐에서 이벤트를 꺼내 처리합니다. 이때 원본 메시지도 그대로 보관해 둡니다. 나중에 개념이 바뀌어 다시 분석할 때 필요하기 때문입니다.
채널에는 새 메시지만 올라오지 않습니다. 이미 올라온 메시지가 수정되거나 삭제되기도 하고, 네트워크 문제로 같은 메시지가 두 번 전달되기도 합니다. 그래서 메시지의 고유한 ID와 마지막 수정 시각을 함께 보고 다음처럼 처리합니다.
| 메시지 | 처리 |
|---|---|
| 처음 보는 메시지 | 새로 처리해 그래프에 넣습니다 |
| ID와 수정 시각이 모두 같은 메시지 | 이미 끝까지 처리했다면 건너뜁니다 |
| ID는 같고 수정 시각이 달라진 메시지 | 그 메시지에서 만든 트리플을 새 내용으로 바꿉니다 |
| 삭제된 메시지 | 그 메시지에서 만든 트리플을 지우거나 삭제 표시를 남깁니다 |
이렇게 하면 수정된 내용은 빠짐없이 반영하면서도, 같은 메시지가 여러 번 들어와도 결과가 달라지지 않도록 처리 과정을 멱등하게 유지할 수 있습니다.
보강(Enrich): 필요한 정보를 찾아 트리플로 만듭니다
보강은 인리처가 메시지에서 필요한 정보를 찾아 트리플로 만드는 단계입니다. 인리처 하나는 여러 코드가 함께 동작하는 작은 프로그램입니다. 앞에서 본 인리처의 틀처럼 외부 시스템에서 데이터를 읽어 오고, 분석하고, 트리플로 내보냅니다. 이 가운데 분석 부분에서는 상황에 맞는 방법을 섞어 씁니다.
- 규칙: 정규식으로 링크를 찾거나 메시지에서 배포 ID를 뽑아내는 것처럼, 같은 입력에는 늘 같은 결과를 냅니다.
- LLM: Slack 스레드가 장애에 관한 것인지 단순한 질문인지 분류하는 것처럼, 정해진 형식이 없는 글을 해석해야 할 때 씁니다. 실행할 때마다 결과가 달라질 수 있으므로, 앞에서 본 것처럼 미리 정해 둔 값 가운데서만 고르게 합니다.
예를 들어 Slack 메시지를 다루는 인리처를 앞의 틀에 맞춰 적어 보면 다음과 같습니다.
class SlackMessageEnricher(Enricher):
    async def _enrich_async(self, message):
        # 1. 읽어 오기: 메시지 원문과 외부 정보
        text = message.text
        deploy_ids = DEPLOY_LINK.findall(text)         # 규칙: 정규식으로 배포 링크 찾기
        app = catalog.lookup(APP_NAME.search(text))    # 규칙: 카탈로그에서 애플리케이션 확인

        # 2. 분석: 정해진 값 가운데서만 고르는 LLM 분류
        category = await llm.classify(
            text, choices=["incident", "question", "discussion", "decision"]
        )

        # 3. 내보내기: 명명 규칙으로 IRI를 만들고, 타입이 정해진 트리플 추가
        msg = iri("slack", message.channel_id, message.ts)
        graph.add((msg, RDF.type, EX.SlackMessage))
        graph.add((msg, SLACK.category, Literal(category)))
        if app:                                        # 카탈로그에 있는 애플리케이션만 연결
            graph.add((msg, EX.about, iri("app", app.catalog_id)))
        for deploy_id in deploy_ids:
            graph.add((msg, EX.mentions, iri("deploy", deploy_id)))
        return EnrichmentResult(success=True, triples_added=count)
인리처 하나 안에서 정규식, 카탈로그 조회, LLM 분류, 명명 규칙이 차례로 쓰입니다. Netflix 발표에서도 정규식이나 ID 추출 같은 규칙과 LLM을 함께 쓴다고 소개합니다. 어떤 방법으로 만들었든 결과는 아래의 검증을 똑같이 통과해야 그래프에 들어갑니다.
하베스터가 메시지를 인리처들에게 차례로 넘기면, 각 인리처는 다음 순서로 일합니다.
- 그래프 읽기: 앞의 인리처가 넣은 결과를 읽습니다. Netflix는 인리처를 동시에 돌리지 않고 하나씩 실행합니다. 그래서 앞 인리처가 이 메시지가 어느 애플리케이션 이야기인지 확정하면, 뒤 인리처가 그 애플리케이션의 배포 이력을 이어 붙일 수 있습니다.
- 외부 정보 가져오기: 배포 이력처럼 다른 시스템에 있는 정보를 조회합니다. 이름이 제각각인 기록을 같은 애플리케이션으로 연결하는 일도 그래프가 아니라 카탈로그를 조회해서 합니다.
- 트리플 만들기: IRI를 발급하는 프로그램을 따로 두지 않고, 인리처가 정해진 명명 규칙에 따라 직접 만듭니다. Netflix도 모든 인리처가 하나의 명명 규칙을 따르도록 정해 두었습니다. 예를 들어 Slack 메시지는 채널과 메시지 ID로, 애플리케이션은 카탈로그 ID로 IRI를 만듭니다. 같은 대상이면 늘 같은 IRI가 나오고 RDF 그래프는 똑같은 트리플을 하나로 취급하므로, 중복을 따로 걸러 낼 필요가 없습니다.
- 자동 검증: 실시간으로 쏟아지는 데이터를 사람이 하나하나 확인할 수는 없으므로, 확인은 자동 검증이 대신합니다. 모든 대상에 타입이 있는지, IRI가 명명 규칙에 맞는지, 애플리케이션이 카탈로그에 있는지를 SHACL과 코드로 검사합니다.
- 저장: 검증을 통과한 결과만 저장합니다. Netflix는 수집할 때마다 그래프를 Turtle 파일로 직렬화해 S3에 남기고, 변경 데이터 캡처(CDC) 스트림으로 바뀐 트리플을 조회용 그래프에 반영합니다. 그래서 에이전트가 조회하는 그래프에는 거의 실시간으로 반영되고, 시점별 기록은 Turtle 파일에 남습니다.
이 과정에서 생기는 실패는 두 가지로 나눠 다룹니다.
| 실패 종류 | 예시 | 처리 |
|---|---|---|
| 다시 시도하면 해결될 수 있는 실패 | 배포 API가 응답하지 않음 | 가져온 정보부터 넣고, 가져오지 못한 항목을 기록한 뒤 나중에 다시 시도 |
| 몇 번을 다시 시도해도 같은 실패 | 카탈로그에 없는 애플리케이션 이름 | 그래프에 넣지 않고 따로 모아 두었다가, 원인을 고친 뒤 다시 처리 |
추론(Infer): 그래프를 읽고 가설과 다음에 확인할 내용을 제안합니다
추론은 에이전트가 그래프를 읽고 가설을 세우거나 다음에 확인할 내용을 제안하는 단계입니다. 에이전트가 하는 일은 다음과 같습니다.
- 조회: SPARQL로 현재 그래프를 조회합니다.
- 가설 기록: 가설을 근거와 함께 트리플로 다시 그래프에 적습니다. 가설도 다른 데이터와 같은 검증을 거치므로, 상태나 근거가 빠진 가설은 저장되지 않습니다.
- 다음 확인 제안: 다음에 확인할 내용을 채널에 메시지로 남깁니다. 사람이 그 결과를 채널에 다시 적으면 그 메시지가 다시 수신기로 들어와 루프가 다시 돌게 됩니다.
판단이 바뀌는 경우도 있습니다. 처음 예시처럼 배포가 원인이 아니라는 정정이 올라오거나, 애플리케이션의 담당 팀이 바뀌는 경우입니다. 이때는 현재 상태를 담는 그래프와 지난 이력을 담는 그래프를 나눠서 기록합니다.
| 내용 | 현재 그래프 | 이력 그래프 |
|---|---|---|
| 배포가 원인이 아니라는 정정 | 배포 원인 가설의 상태를 바꿈 | 언제, 무엇을 근거로 바꿨는지 |
| 담당 팀 변경 (Team Bedrock → Team Edge) | 현재 담당 팀인 Team Edge만 남김 | 예전 담당 팀과 담당 기간 |
두 사실을 한 그래프에 그대로 두면, 에이전트가 담당 팀을 조회했을 때 두 팀이 함께 나와서 어느 쪽이 지금 담당 팀인지 알 수 없습니다. 그래서 에이전트는 평소에는 현재 그래프만 보고, "그 장애가 났을 때 담당 팀은 누구였는가"처럼 과거를 물을 때만 이력 그래프를 봅니다. 이런 변화는 모두 이미 정해 둔 관계와 값 안에서 일어나므로 개념은 바꿀 필요가 없습니다.
반영(Adapt): 개념이 바뀌는 경우, 확인한 뒤 반영합니다
반영은 루프를 돌면서 드러난 부족한 점을 바탕으로 온톨로지와 인리처를 고치는 단계입니다. 온톨로지의 개념 자체가 바뀌는 것도 이 단계에서입니다.
개념을 바꿔야 한다는 신호는 세 군데서 확인합니다.
- 보강 단계 데이터: 카탈로그에 없는 이름이나 허용되지 않은 값이 계속 쌓인다면, 개념이나 이름 매핑이 현실을 따라가지 못하고 있다는 뜻입니다.
- LLM 제안: Netflix에서는 LLM이 정해진 값으로 담을 수 없는 새 유형을 만나면, 값을 지어내지 않고 새 정의나 새 인리처가 필요하다고 알려 줍니다.
- 사람의 검토: 사람이 추론 결과를 검토하다가 문제를 발견하기도 합니다.
이렇게 모인 제안은 곧바로 그래프에 반영되지 않고 다음 과정을 거칩니다.
- 에이전트나 사람이 온톨로지 파일과 인리처 코드를 고친 브랜치를 만듭니다.
- 브랜치마다 테스트를 돌립니다.
- 테스트를 통과한 브랜치를 사람이 검토해서 합칩니다.
- 합친 변경은 아래에서 설명하는 새 그래프 비교를 거쳐 운영에 반영합니다.
정리하면, 자동 검증과 LLM 검증을 진행한 다음, 개념을 바꿀지는 사람이 결정합니다.
예를 들어 Slack 스레드의 분류 값이 "incident", "question", "discussion", "decision" 네 가지뿐인데 정기 점검("maintenance")을 따로 구분하고 싶다면, 개념 자체를 바꿔야 합니다. 이때 이미 쌓인 데이터를 어떻게 할지는 무엇이 바뀌었는지에 따라 달라집니다.
| 내용 | 예시 | 기존 데이터 처리 |
|---|---|---|
| 새 분류 추가 | "maintenance" 분류를 새로 추가 | 앞으로 들어오는 데이터에만 적용해도 된다면 과거 데이터는 그대로 둡니다 |
| 이름만 변경 | ex:owner를 ops:ownedBy로 통일 | 규칙에 따라 기존 데이터를 한꺼번에 바꿉니다 |
| 의미 변경 | 지난 장애 수에서 정기 점검을 빼야 함 | 예전에 "incident"로 분류한 스레드를 원본 메시지부터 다시 분석합니다 |
이름만 바꿀 때는 예전 이름에 OWL의 owl:deprecated로 더 이상 쓰지 않는다는 표시를 남기고, SHACL 규칙(sh:maxCount 0)으로 예전 이름이 새로 들어오지 않게 막습니다. 의미가 바뀔 때는 이름만 바꿔서는 무엇이 정기 점검이었는지 알 수 없으므로 다시 분석해야 합니다. 원본을 보관해 두지 않았다면 다시 분석할 수 없다는 점도 기억해 둬야 합니다.
새로운 그래프로 업데이트
온톨로지나 인리처를 고쳤다고 해서 운영 중인 그래프를 곧바로 덮어쓰지는 않습니다. 기존 그래프(v1)는 그대로 두고, 바뀐 규칙으로 새 그래프(v2)를 따로 만듭니다. 그리고 두 그래프의 결과를 비교해 문제가 없을 때만 에이전트가 조회하는 대상을 v2로 바꿉니다. 코드를 배포하기 전에 테스트를 통과해야 하는 것과 같은 원리입니다.
두 그래프는 회귀 테스트를 할 때처럼 다음 기준을 고정해 두고 비교합니다.
- 같은 입력: v1과 v2를 같은 원본 데이터로 만듭니다. 입력이 같아야 결과의 차이가 규칙 때문인지 가려낼 수 있습니다.
- 같은 질문: "이 장애가 영향을 준 애플리케이션은 무엇인가", "당시 담당 팀은 누구였는가"처럼 운영에서 실제로 쓰는 질문을 평가 쿼리로 정해 두 그래프에서 똑같이 실행합니다.
- 통과 기준: 이번 변경으로 달라져야 하는 결과와 달라지면 안 되는 결과를 미리 나눕니다. 정기 점검("maintenance")이 추가되어 따로 분류했다면 장애 수가 줄어드는 것은 의도한 변화입니다. 반면 관계 이름만 통일했는데 담당 팀이 조회되지 않는다면 바뀌면 안 되는 결과가 바뀐 것이므로 v2로 전환하지 않습니다.
어떤 데이터와 질문을 기준으로 삼을지는 팀의 환경에 따라 다릅니다. 다만 기준을 결과보다 먼저 정해 두어야 "이 정도 차이는 괜찮다"며 넘어가는 일을 막을 수 있습니다. Netflix도 발표에서 비슷한 흐름을 보여 줍니다. 에이전트가 인리처를 고친 내용은 브랜치마다 테스트를 거치고, 테스트를 통과한 브랜치 가운데 필요한 것만 사람이 골라 합칩니다.
v2로 전환한 뒤에도 v1을 바로 지우지는 않습니다. 운영 중에 문제가 드러나면 조회 대상을 다시 v1으로 돌려야 하기 때문입니다. 이때 v1이 전환 시점 이후에 멈춰 있으면 그 뒤에 들어온 기록을 조회할 수 없으므로, 일정 기간은 v1에도 새 데이터를 계속 넣어 둡니다. 또 각 그래프를 만들 때 쓴 온톨로지, 검증 규칙, 인리처의 버전을 함께 기록해 두어야, 나중에 결과가 달라졌을 때 어떤 변경 때문인지 확인할 수 있습니다.
평가 데이터셋은 처음부터 크게 만들 필요가 없습니다. 한 건으로 시작하되, 같은 메시지가 두 번 들어오는 경우, 외부 API 조회가 실패하는 경우, 가설이 정정되는 경우처럼 앞에서 다룬 상황을 함께 넣어 두면 좋습니다. 그러면 정상적인 흐름뿐 아니라 실패했을 때의 처리까지 같은 기준으로 확인할 수 있습니다.
작은 사례 하나로 시작하기
처음부터 모든 내용을 정리할 필요는 없습니다. 작은 사례 하나로 다음 세 단계를 해 보면 됩니다.
- 먼저 지난 장애처럼 이미 지나간 이벤트 하나를 고릅니다. 당시 어떤 증거가 있었고 어떤 조치를 했는지 트리플로 적어서 서로 연결합니다.
- 다음으로 한 리전에서만 타임아웃이 난 이번 장애처럼, 지금 다루는 상황을 같은 방식으로 적어서 예전 기록과 비교할 수 있게 만듭니다. 이때 배포 이력을 가져오지 못한 경우처럼 정보가 빠진 상황도 일부러 넣어 봅니다.
- 마지막으로 이 자료를 에이전트에게 주고 결과를 살펴봅니다. 에이전트가 어떤 지표나 설정을 더 확인해야 한다고 제안하는지, 그리고 왜 그렇게 생각했는지 근거까지 설명하는지 확인합니다.
이 세 단계만 거쳐 봐도 우리가 정리한 자료가 에이전트에게 얼마나 도움이 되는지 감을 잡을 수 있습니다.
마치며
일이 끝나면 무엇을 했는지는 기록에 남아도, 무엇을 보고 그렇게 판단했는지는 그 일을 직접 한 사람만 기억하기 쉽습니다. 어떤 선택은 왜 하지 않았는지, 무엇을 보고 생각을 바꿨는지까지 적는 일은 쉽지 않습니다. 그래서 나중에 비슷한 일이 생기면, 그때 왜 그런 판단을 했는지 기억하기 쉽지 않습니다.
온톨로지로 대상과 관계를 정하고 판단의 근거를 연결해 두면, 다른 사람과 에이전트도 당시 무엇을 확인했는지 어렵지 않게 확인할 수 있습니다. 누군가에게 묻지않아도 사람이나 에이전트가 쉽게 확인할 수 있습니다.
Netflix처럼 처음부터 온톨로지를 완전하게 갖출 필요는 없습니다. 우리 팀이 다루는 시스템에 무엇이 있는지, 그것들을 서로 어떤 이름으로 부르고 있는지 적어 보는 것만으로도 좋은 출발이 됩니다.